Dans notre précédent article, nous avons présenté ce que sait faire GTPCProxy ; regardons maintenant à l’intérieur pour détailler son architecture et les résultats des mesures.
Un cœur multithread sans structures partagées
L’idée principale est que les threads de travail du proxy ne se gênent pas mutuellement. Toutes les sessions de GTPCProxy sont réparties en 1 024 partitions. Chaque partition est attribuée à un seul thread de travail, et un thread dessert de nombreuses partitions.
Il n’existe aucune structure modifiable partagée entre plusieurs threads. Les threads de travail n’ont donc pas à coordonner l’accès aux données, et chaque nouveau thread ajoute de la performance presque sans perte. Les mesures le confirment : à 50 % de la charge maximale, aucun blocage des threads de travail n’a été enregistré sur une minute.
Les réponses des passerelles PGW et les messages de vérification Echo, qui permettent au proxy de savoir qu’une passerelle est vivante, passent par une file d’attente distincte, et non avec les nouvelles requêtes. Ainsi, même en pic de charge, les réponses sont traitées sans délai et les vérifications respectent le temps imparti. Le proxy ne prendra pas une passerelle opérationnelle pour une passerelle en panne simplement parce qu’il était lui-même occupé.
Si le proxy est malgré tout surchargé, il traite les messages par ordre d’importance. Les messages relatifs aux sessions déjà établies passent en premier, puis les demandes de nouvelles connexions. Ainsi, les abonnés déjà connectés ne pâtissent pas d’un afflux de nouveaux abonnés.
Mise à l’échelle verticale : résultats des mesures
Le proxy enregistre l’état de chaque session dans Redis, une base de données rapide qui conserve tout en mémoire vive. Il peut s’agir d’un seul serveur Redis ou d’un cluster dans lequel chaque nœud dispose d’une copie de secours (réplique).
Nous recommandons ce schéma
Chaque thread de travail dispose de son propre canal d’écriture vers le stockage et de son propre nœud principal Redis avec réplique.
Avec ce schéma, nous avons mesuré combien de requêtes Modify Bearer le proxy traite de façon continue et sans erreur. (Modify Bearer est une requête de modification des paramètres d’une session d’abonné déjà existante) :
| Threads de travail | Modify Bearer par seconde | Progression par rapport à la ligne précédente |
| 1 | 87 812 | — |
| 2 | 180 625 | × 2,06 |
| 4 | 348 203 | × 1,93 |
En passant d’un à deux threads, la capacité a été multipliée par 2,06, et de deux à quatre, par 1,93. Quatre threads traitent 348 203 requêtes par seconde. C’est 0,9 % de moins que quatre fois la capacité d’un seul thread (351 248).
La latence a été mesurée sur quatre threads à 90 % de la charge maximale pendant 30 minutes. Résultats :
- p50 : 0,10 ms,
- p99 : 0,33 ms,
- p99,9 : 0,56 ms.
En 30 minutes, le proxy a traité 563 776 014 transactions sans erreur ni perte. La mémoire du processus a augmenté de 7,9 Mo sur cette période.
Pour les petits réseaux, un Redis unique suffit. Mais un Redis unique limite la capacité. Le proxy traite alors environ 105 000 requêtes Modify Bearer par seconde, et l’ajout de threads de travail n’augmente pas ce chiffre.
Si l’on attribue à un cluster Redis autant de cœurs de processeur qu’à un serveur unique, la capacité du proxy baisse d’environ 21 à 22 %. En revanche, si chaque nœud principal du cluster dispose de son propre cœur, la performance augmente avec le nombre de threads de travail du proxy.
Mise à l’échelle horizontale et redondance via BGP
Pour que le proxy ne devienne pas un point de défaillance unique, ses instances sont regroupées. Chaque groupe possède sa propre adresse IP (/32), que les instances annoncent via BGP comme joignable par leur intermédiaire. L’instance active annonce l’adresse avec la meilleure route, l’instance de secours avec une route moins bonne : le trafic va donc vers l’instance active.
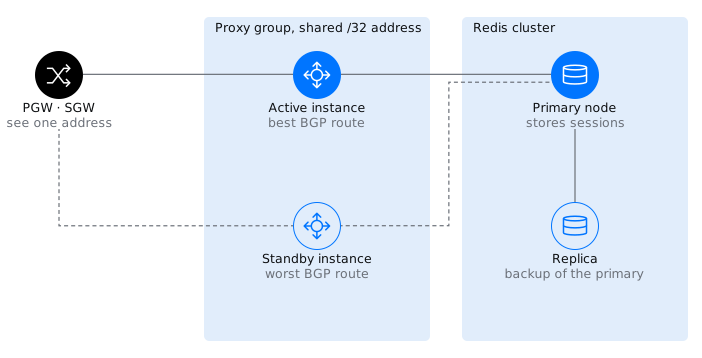
Figure : Les nœuds voisins s’adressent toujours à une seule adresse de groupe. C’est BGP qui décide quelle instance répond, et les deux lisent les sessions dans le même Redis.
Panne du proxy ou du serveur
Un programme distinct, le watchdog BGP, surveille le processus du proxy. Il le vérifie une fois par seconde. Si une instance est défaillante pendant plus de 10 secondes, le watchdog cesse d’annoncer son adresse et le trafic bascule vers l’instance de secours. L’instance ne peut reprendre du service qu’après 30 secondes de fonctionnement stable. Ainsi, une instance instable ne disparaît pas et ne réapparaît pas sans cesse.
Si c’est tout le serveur ou sa connexion réseau qui tombe en panne, le mécanisme BFD se déclenche. Il détecte la coupure en 900 ms, après trois vérifications manquées à intervalles de 300 ms. L’adresse passe alors à l’instance de secours.
Pourquoi les sessions ne sont pas perdues
Lorsqu’elle reçoit un message relatif à une session, l’instance de secours lit l’état de cette session dans Redis à partir de l’identifiant de tunnel (TEID).
Les nœuds voisins ne remarquent pas non plus la bascule. Chaque nœud communique à ses voisins son compteur de redémarrages (Recovery). Si le compteur change, le voisin considère que le nœud a redémarré et supprime les sessions qui lui sont associées. Toutes les instances d’un groupe ont la même valeur Recovery : le SGW et le PGW ne prennent donc pas la bascule pour un redémarrage, et les sessions sont conservées.
Panne de Redis
En cas de panne du nœud principal Redis, ses fonctions passent à la réplique. Lors d’une série d’essais avec une charge de 6 020 requêtes de création de connexion par seconde, la bascule a pris au maximum 2,03 s.
Redémarrage du proxy
Le redémarrage du proxy n’interrompt pas les connexions. Le processus démarre en environ 0,135 s (médiane), puis lit l’état des sessions dans Redis. Un thread de travail bloqué est redémarré par le temporisateur watchdog du thread, un mécanisme distinct, sans lien avec le watchdog BGP. Lors d’un arrêt planifié, le proxy répond d’abord aux transactions en cours.
Comment augmenter la capacité
Pour desservir davantage d’abonnés, on ajoute de nouveaux groupes de proxy. Leurs adresses sont inscrites dans le DNS pour les points d’accès (APN) concernés. Tous les groupes fonctionnent avec un même cluster Redis.
| Événement | Mode de détection | Délai |
| Défaillance du processus proxy | Watchdog BGP, vérification une fois par seconde | Adresse retirée au bout de 10 s |
| Panne du serveur ou du réseau | BFD, intervalle de 300 ms, 3 échecs | 900 ms |
| Remise en service de l’instance | Watchdog BGP | Après 30 s de fonctionnement stable |
| Panne du nœud principal Redis | Bascule vers la réplique | Jusqu’à 2,03 s |
| Démarrage du processus proxy | — | 0,135 s (médiane) |
VNF ou CNF
Le proxy est proposé en deux variantes. La redondance y fonctionne de la même manière ; seuls changent l’endroit et la manière dont le proxy est exécuté. La première variante est une machine virtuelle (VNF), la seconde des conteneurs dans Kubernetes (CNF).
| Machine virtuelle (VNF) | Kubernetes (CNF) | |
| Plateforme | VEOS 8 | Kubernetes |
| Source d’installation | Deux paquets RPM | Image construite à partir des mêmes paquets RPM, et chart Helm |
| Mode d’exécution | Service système (systemd) | StatefulSet, deux pods par groupe |
| Qui annonce l’adresse du groupe | FRR et le watchdog BGP | FRR dans le pod du proxy |
| Ressources et paramètres | — | Affectation statique des cœurs de processeur, configuration dans ConfigMap et Secret |
La machine virtuelle se met à jour avec la commande dnf upgrade. On met d’abord à jour l’instance de secours, puis l’instance active.
Supervision et administration
Les métriques Prometheus couvrent les messages, les transactions, les pannes, ainsi que l’état des PGW et du stockage. Des tableaux de bord Grafana prêts à l’emploi sont intégrés à l’interface web du proxy. On y trouve aussi des indicateurs de synthèse, les tableaux des PGW et des pools, la recherche de session et sa fiche détaillée, y compris avec les paramètres des réseaux 2G/3G (GTPv1).
L’interface reste rapide même avec un grand nombre de sessions. Avec 100 000 sessions, la première page de la liste s’ouvre en 6,9 ms, et la recherche par numéro de carte SIM (IMSI) prend 0,4 ms.
Les paramètres sont répartis sur deux niveaux.
- Le fichier gtpcp.yaml concerne le proxy lui-même. Il définit les adresses, le nombre de threads, l’affectation aux cœurs de processeur et les paramètres du stockage.
- Le document de routage concerne le traitement des abonnés. Il définit les pools de passerelles, les règles de sélection, les poids, les vérifications d’état des PGW et la substitution de paramètres.
Le document de routage peut être modifié sans redémarrer le proxy, via des formulaires ou sous forme de texte dans l’interface web. Avant de l’appliquer, le proxy valide la nouvelle version. Si elle contient une erreur, le proxy continue de fonctionner avec la version actuelle. Il est toujours possible de revenir à la version précédente. Les droits sont répartis entre deux rôles : administrateur et observateur.
Conclusion
GTPCProxy augmente ses performances grâce à de nouveaux cœurs de processeur et de nouveaux groupes de proxy, et conserve l’état des sessions séparément, dans Redis. C’est pourquoi la bascule vers l’instance de secours passe inaperçue pour le SGW et le PGW, qui n’ont rien à faire pour cela.
Vous pouvez le vérifier sur vos propres SGW, SGSN et PGW en laboratoire. VAS Experts fournit un pack d’essais comprenant la configuration, les scénarios et un ensemble d’outils de collecte de traces. Contactez-nous pour planifier la validation.