No artigo anterior, mostramos o que o GTPCProxy é capaz de fazer; agora vamos olhar por dentro, explicar como ele funciona e mostrar os resultados das medições.
Núcleo multithread sem estruturas compartilhadas
A ideia principal é que as threads de trabalho do proxy não atrapalham umas às outras. Todas as sessões do GTPCProxy são divididas em 1.024 partições. Cada partição fica vinculada a uma única thread de trabalho, e uma thread atende muitas partições.
Não há estruturas mutáveis compartilhadas entre várias threads. Por isso, as threads de trabalho não precisam coordenar o acesso aos dados, e cada nova thread acrescenta desempenho quase sem perdas. As medições confirmam isso: com 50% da carga máxima, não foi registrado nenhum bloqueio das threads de trabalho em um minuto.
As respostas dos gateways PGW e as mensagens de verificação Echo, pelas quais o proxy sabe que o gateway está ativo, passam por uma fila separada, e não junto com as novas requisições. Assim, mesmo no pico de carga, as respostas são processadas sem atraso e as verificações cumprem o tempo previsto. O proxy não vai confundir um gateway saudável com um que falhou só porque ele próprio estava ocupado.
Se ainda assim o proxy ficar sobrecarregado, ele atende as mensagens por prioridade. Primeiro vêm as mensagens das sessões já ativas e, depois, as requisições de novas conexões. Dessa forma, os assinantes que já estão na rede não são prejudicados por um pico de novos acessos.
Escalabilidade vertical: resultados das medições
O proxy grava o estado de cada sessão no Redis, um banco de dados rápido que mantém tudo na memória RAM. Pode ser um único servidor Redis ou um cluster em que cada nó tem uma cópia de reserva (réplica).
Recomendamos este esquema
Cada thread de trabalho tem seu próprio canal de gravação no armazenamento e seu próprio nó principal do Redis com réplica.
Nesse esquema, medimos quantas requisições Modify Bearer o proxy processa de forma contínua e sem erros. (Modify Bearer é uma requisição para alterar os parâmetros de uma sessão já existente do assinante):
| Threads de trabalho | Modify Bearer por segundo | Crescimento em relação à linha anterior |
| 1 | 87.812 | — |
| 2 | 180.625 | 2,06 vezes |
| 4 | 348.203 | 1,93 vez |
Ao passar de uma para duas threads, a capacidade cresceu 2,06 vezes e, de duas para quatro, 1,93 vez. Quatro threads processam 348.203 requisições por segundo. Isso é 0,9% menos do que quatro vezes a capacidade de uma única thread (351.248).
A latência foi medida com quatro threads e 90% da carga máxima durante 30 minutos. Resultados:
- p50: 0,10 ms,
- p99: 0,33 ms,
- p99,9: 0,56 ms.
Em 30 minutos, o proxy processou 563.776.014 transações sem erros nem perdas. A memória do processo cresceu 7,9 MB nesse período.
Para redes pequenas, um Redis único é suficiente. Mas um Redis único limita a capacidade. O proxy processa cerca de 105.000 requisições Modify Bearer por segundo, e adicionar threads de trabalho não aumenta esse número.
Se o cluster Redis receber o mesmo número de núcleos de processador que um servidor único, a capacidade do proxy cai cerca de 21–22%. Já se cada nó principal do cluster receber um núcleo próprio, o desempenho cresce junto com o número de threads de trabalho do proxy.
Escalabilidade horizontal e redundância via BGP
Para que o proxy não se torne um ponto único de falha, suas instâncias são reunidas em grupos. Cada grupo tem seu próprio endereço IP (/32), que as instâncias anunciam via BGP como acessível por meio delas. A instância ativa anuncia o endereço com a melhor rota, e a de reserva, com uma rota pior; por isso, o tráfego vai para a ativa.
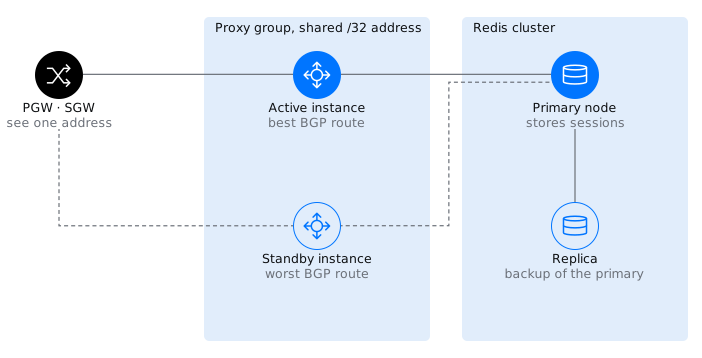
Figura: Os nós vizinhos sempre se comunicam com um único endereço do grupo. O BGP decide qual instância responde no momento, e ambas leem as sessões do mesmo Redis.
Falha do proxy ou do servidor
Um programa separado, o watchdog do BGP, monitora o processo do proxy. Ele verifica o processo uma vez por segundo. Se uma instância ficar com falha por mais de 10 segundos, o watchdog deixa de anunciar seu endereço, e o tráfego passa para a instância de reserva. A instância só pode voltar a operar depois de 30 segundos de funcionamento estável. Assim, uma instância instável não fica sumindo e reaparecendo.
Se o servidor inteiro ou a conexão de rede dele falhar, entra em ação o mecanismo BFD. Ele detecta a queda em 900 ms, após três verificações perdidas com intervalo de 300 ms. Em seguida, o endereço passa para a instância de reserva.
Por que as sessões não se perdem
Ao receber uma mensagem de uma sessão, a instância de reserva lê o estado dessa sessão no Redis pelo identificador do túnel (TEID).
Os nós vizinhos também não percebem a troca. Cada nó informa aos vizinhos o seu contador de reinicializações (Recovery). Se o contador mudar, o vizinho entende que o nó foi reiniciado e apaga as sessões associadas a ele. Todas as instâncias do grupo têm o mesmo valor de Recovery, por isso o SGW e o PGW não confundem a troca com uma reinicialização, e as sessões são mantidas.
Falha do Redis
Quando o nó principal do Redis falha, suas funções passam para a réplica. Em uma série de testes com carga de 6.020 requisições de criação de conexão por segundo, a troca levou no máximo 2,03 s.
Reinicialização do proxy
A reinicialização do proxy não derruba as conexões. O processo em si inicia em cerca de 0,135 s (mediana) e depois lê o estado das sessões no Redis. Uma thread de trabalho travada é reiniciada pelo timer watchdog da thread, um mecanismo separado, sem relação com o watchdog do BGP. Em uma parada planejada, o proxy primeiro responde às transações em aberto.
Como aumentar a capacidade
Para atender mais assinantes, são adicionados novos grupos de proxy. Os endereços deles são registrados no DNS para os pontos de acesso (APNs) desejados. Todos os grupos trabalham com um único cluster Redis.
| Evento | Como é detectado | Tempo |
| Falha do processo do proxy | Watchdog do BGP, verificação uma vez por segundo | Endereço retirado após 10 s |
| Falha do servidor ou da rede | BFD, intervalo de 300 ms, 3 perdas | 900 ms |
| Retorno da instância à operação | Watchdog do BGP | Após 30 s de funcionamento estável |
| Falha do nó principal do Redis | Troca para a réplica | Até 2,03 s |
| Inicialização do processo do proxy | — | 0,135 s (mediana) |
VNF ou CNF
O proxy é fornecido em duas versões. A redundância funciona da mesma forma em ambas; a diferença está apenas em onde e como o proxy é executado. A primeira versão é uma máquina virtual (VNF), e a segunda, contêineres no Kubernetes (CNF).
| Máquina virtual (VNF) | Kubernetes (CNF) | |
| Plataforma | VEOS 8 | Kubernetes |
| A partir de que é instalado | Dois pacotes RPM | Imagem criada a partir dos mesmos pacotes RPM e Helm chart |
| Como é executado | Serviço do sistema (systemd) | StatefulSet, dois pods por grupo |
| Quem anuncia o endereço do grupo | FRR e o watchdog do BGP | FRR dentro do pod do proxy |
| Recursos e configurações | — | Fixação estática de núcleos de processador, configuração em ConfigMap e Secret |
A máquina virtual é atualizada com o comando dnf upgrade. Primeiro atualiza-se a instância de reserva e, depois, a ativa.
Monitoramento e gerenciamento
As métricas do Prometheus abrangem mensagens, transações, falhas e o estado dos PGWs e do armazenamento. Painéis prontos do Grafana estão integrados à interface web do proxy. Nela também estão disponíveis indicadores consolidados, tabelas de PGWs e pools, busca de sessões e a ficha de cada sessão, inclusive com parâmetros de redes 2G/3G (GTPv1).
A interface é rápida mesmo com um grande número de sessões. Com 100.000 sessões, a primeira página da lista abre em 6,9 ms, e a busca pelo número do chip SIM (IMSI) leva 0,4 ms.
As configurações são divididas em dois níveis.
- O arquivo gtpcp.yaml controla o próprio proxy. Nele são definidos os endereços, o número de threads, a vinculação aos núcleos de processador e os parâmetros do armazenamento.
- O documento de roteamento controla o tratamento dos assinantes. Nele são definidos os pools de gateways, as regras de seleção, os pesos, as verificações de estado dos PGWs e a substituição de parâmetros.
O documento de roteamento pode ser alterado sem reiniciar o proxy, por meio de formulários ou em formato de texto na interface web. Antes de aplicá-la, o proxy valida a nova versão. Se houver um erro, o proxy continua funcionando com a versão atual. Sempre é possível voltar à versão anterior. As permissões são divididas entre dois perfis: administrador e observador.
Conclusão
O GTPCProxy aumenta o desempenho com novos núcleos de processador e novos grupos de proxy, e armazena o estado das sessões separadamente, no Redis. Por isso, a troca para a instância de reserva passa despercebida pelo SGW e pelo PGW, que não precisam fazer nada para isso.
Você pode comprovar isso nos seus próprios SGWs, SGSNs e PGWs em laboratório. A VAS Experts fornece um pacote de testes com configuração, cenários e um conjunto de ferramentas para coleta de traces. Fale com a gente para planejar a validação.