En el artículo anterior contamos qué puede hacer GTPCProxy; ahora vamos a mirar por dentro y a explicar cómo está construido GTPCProxy y los resultados de las mediciones.
Núcleo multihilo sin estructuras compartidas
La idea principal es que los hilos de trabajo del proxy no se interfieren entre sí. Todas las sesiones de GTPCProxy están divididas en 1024 particiones. Cada partición está asignada a un solo hilo de trabajo, y un hilo atiende muchas particiones.
No hay estructuras modificables compartidas entre varios hilos. Por eso los hilos de trabajo no necesitan coordinar el acceso a los datos, y cada hilo nuevo suma rendimiento casi sin pérdidas. Las mediciones lo confirman: con una carga del 50 % de la máxima, en un minuto no se registró ni un solo bloqueo de los hilos de trabajo.
Las respuestas de los gateways PGW y los mensajes de verificación Echo, con los que el proxy sabe que un gateway está activo, pasan por una cola separada y no junto con las solicitudes nuevas. Por eso, incluso en el pico de carga, las respuestas se procesan sin demora y las verificaciones se completan en el tiempo previsto. El proxy no confundirá un gateway que funciona bien con uno caído solo porque él mismo estaba ocupado.
Si aun así el proxy se sobrecarga, atiende los mensajes por prioridad. Primero van los mensajes de las sesiones ya activas y después las solicitudes de nuevas conexiones. Así, los suscriptores que ya están en la red no se ven afectados por una avalancha de nuevos.
Escalamiento vertical: resultados de las mediciones
El proxy registra el estado de cada sesión en Redis, una base de datos rápida que guarda todo en memoria RAM. Puede ser un solo servidor Redis o un clúster en el que cada nodo tiene una copia de respaldo (réplica).
Recomendamos este esquema
Cada hilo de trabajo tiene su propio canal de escritura en el almacenamiento y su propio nodo principal de Redis con réplica.
Con este esquema medimos cuántas solicitudes Modify Bearer procesa el proxy de forma sostenida y sin errores. (Modify Bearer es una solicitud para modificar los parámetros de una sesión ya existente del suscriptor):
| Hilos de trabajo | Modify Bearer por segundo | Crecimiento respecto a la fila anterior |
| 1 | 87 812 | — |
| 2 | 180 625 | 2,06 veces |
| 4 | 348 203 | 1,93 veces |
Al pasar de uno a dos hilos, la capacidad creció 2,06 veces, y de dos a cuatro, 1,93 veces. Cuatro hilos procesan 348 203 solicitudes por segundo. Es un 0,9 % menos que cuatro veces la capacidad de un solo hilo (351 248).
La latencia se midió con cuatro hilos y una carga del 90 % de la máxima durante 30 minutos. Resultados:
- p50: 0,10 ms,
- p99: 0,33 ms,
- p99,9: 0,56 ms.
En 30 minutos, el proxy procesó 563 776 014 transacciones sin errores ni pérdidas. En ese tiempo, la memoria del proceso creció 7,9 MB.
Para redes pequeñas basta con un Redis individual. Pero un Redis individual limita la capacidad. El proxy procesa unas 105 000 solicitudes Modify Bearer por segundo, y agregar hilos de trabajo no aumenta esa cifra.
Si a un clúster Redis se le asignan tantos núcleos de procesador como a un servidor individual, la capacidad del proxy baja aproximadamente un 21–22 %. En cambio, si a cada nodo principal del clúster se le asigna un núcleo propio, el rendimiento crece junto con el número de hilos de trabajo del proxy.
Escalamiento horizontal y redundancia mediante BGP
Para que el proxy no se convierta en un punto único de falla, sus instancias se agrupan. Cada grupo tiene su propia dirección IP (/32), que las instancias anuncian por BGP como accesible a través de ellas. La instancia activa anuncia la dirección con la mejor ruta y la de respaldo, con una peor, por lo que el tráfico va a la activa.
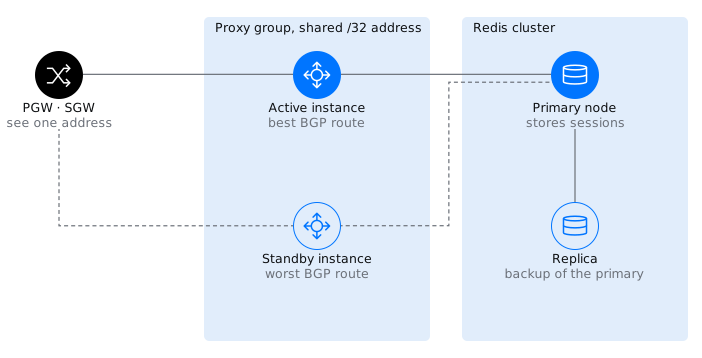
Figura: Los nodos vecinos siempre se dirigen a una sola dirección del grupo. BGP decide qué instancia responde en cada momento, y ambas toman las sesiones del mismo Redis.
Falla del proxy o del servidor
Un programa independiente, el watchdog de BGP, supervisa el proceso del proxy. Lo verifica una vez por segundo. Si una instancia falla durante más de 10 segundos, el watchdog deja de anunciar su dirección y el tráfico pasa a la instancia de respaldo. La instancia solo podrá volver a operar después de 30 segundos de funcionamiento estable. Así, una instancia inestable no estará desapareciendo y reapareciendo.
Si falla todo el servidor o su conexión de red, se activa el mecanismo BFD. Detecta la caída en 900 ms, tras tres verificaciones perdidas con un intervalo de 300 ms. Después, la dirección pasa a la instancia de respaldo.
Por qué no se pierden las sesiones
Al recibir un mensaje de una sesión, la instancia de respaldo lee el estado de esa sesión en Redis por el identificador del túnel (TEID).
Los nodos vecinos tampoco notan el cambio. Cada nodo informa a sus vecinos su contador de reinicios (Recovery). Si el contador cambia, el vecino considera que el nodo se reinició y elimina las sesiones asociadas a él. Todas las instancias del grupo tienen el mismo valor de Recovery, por lo que el SGW y el PGW no confunden el cambio con un reinicio y las sesiones se mantienen.
Falla de Redis
Si falla el nodo principal de Redis, sus funciones pasan a la réplica. En una serie de pruebas con una carga de 6020 solicitudes de creación de conexión por segundo, el cambio tardó como máximo 2,03 s.
Reinicio del proxy
Reiniciar el proxy no corta las conexiones. El proceso en sí arranca en unos 0,135 s (mediana) y luego lee el estado de las sesiones desde Redis. Un hilo de trabajo bloqueado se reinicia mediante el temporizador watchdog del hilo, un mecanismo independiente que no tiene relación con el watchdog de BGP. En una detención planificada, el proxy primero responde a las transacciones abiertas.
Cómo aumentar la capacidad
Para atender a más suscriptores, se agregan nuevos grupos de proxy. Sus direcciones se registran en el DNS para los puntos de acceso (APN) correspondientes. Todos los grupos trabajan con un mismo clúster Redis.
| Evento | Cómo se detecta | Tiempo |
| Falla del proceso del proxy | Watchdog de BGP, verificación una vez por segundo | La dirección se retira a los 10 s |
| Falla del servidor o de la red | BFD, intervalo de 300 ms, 3 pérdidas | 900 ms |
| Regreso de la instancia a operación | Watchdog de BGP | Tras 30 s de funcionamiento estable |
| Falla del nodo principal de Redis | Paso a la réplica | Hasta 2,03 s |
| Arranque del proceso del proxy | — | 0,135 s (mediana) |
VNF o CNF
El proxy se ofrece en dos variantes. La redundancia funciona igual en ambas; la diferencia está solo en dónde y cómo se ejecuta el proxy. La primera variante es una máquina virtual (VNF) y la segunda, contenedores en Kubernetes (CNF).
| Máquina virtual (VNF) | Kubernetes (CNF) | |
| Plataforma | VEOS 8 | Kubernetes |
| Desde qué se instala | Dos paquetes RPM | Imagen construida a partir de los mismos paquetes RPM y un Helm chart |
| Cómo se ejecuta | Servicio del sistema (systemd) | StatefulSet, dos pods por grupo |
| Quién anuncia la dirección del grupo | FRR y el watchdog de BGP | FRR dentro del pod del proxy |
| Recursos y configuración | — | Asignación estática de núcleos de procesador, configuración en ConfigMap y Secret |
La máquina virtual se actualiza con el comando dnf upgrade. Primero se actualiza la instancia de respaldo y después la activa.
Monitoreo y administración
Las métricas de Prometheus abarcan mensajes, transacciones, fallas y el estado de los PGW y del almacenamiento. Los paneles de Grafana ya preparados están integrados en la interfaz web del proxy. Allí también están disponibles los indicadores generales, las tablas de PGW y pools, la búsqueda de sesiones y la ficha de cada sesión, incluidos los parámetros de las redes 2G/3G (GTPv1).
La interfaz funciona rápido incluso con una gran cantidad de sesiones. Con 100 000 sesiones, la primera página de la lista se abre en 6,9 ms, y la búsqueda por número de tarjeta SIM (IMSI) tarda 0,4 ms.
La configuración se divide en dos niveles.
- El archivo gtpcp.yaml se encarga del propio proxy. En él se definen las direcciones, el número de hilos, la asignación a núcleos de procesador y los parámetros del almacenamiento.
- El documento de enrutamiento se encarga del trabajo con los suscriptores. En él se definen los pools de gateways, las reglas de selección, los pesos, las verificaciones del estado de los PGW y la sustitución de parámetros.
El documento de enrutamiento se puede modificar sin reiniciar el proxy, mediante formularios o en formato de texto en la interfaz web. Antes de aplicarla, el proxy valida la nueva versión. Si contiene un error, el proxy sigue funcionando con la actual. Siempre es posible volver a la versión anterior. Los permisos se reparten entre dos roles: administrador y observador.
Conclusión
GTPCProxy aumenta su rendimiento con nuevos núcleos de procesador y nuevos grupos de proxy, y guarda el estado de las sesiones por separado, en Redis. Por eso el cambio a la instancia de respaldo pasa inadvertido para el SGW y el PGW, que no necesitan hacer nada.
Puede comprobarlo con sus propios SGW, SGSN y PGW en laboratorio. VAS Experts entrega un paquete de pruebas con configuración, escenarios y un conjunto de herramientas para recopilar trazas. Contáctenos para planificar la validación.