Architecture du cluster : Control Plane et User Plane
Au sein du cluster, les composants sont répartis entre le Control Plane et le User Plane.
Le User Plane assure les fonctions de traitement du trafic : réception, traitement et transmission du trafic des abonnés.
L’une des fonctions clés du User Plane est le DPI, un système de classification du trafic par sessions et applications. Les nœuds DPI reçoivent les paquets, traitent les connexions, appliquent les politiques nécessaires et collectent les statistiques de consommation des abonnés. Ce sont ces nœuds qui sont ajoutés lorsque la capacité doit être augmentée ou retirés du service pour maintenance.
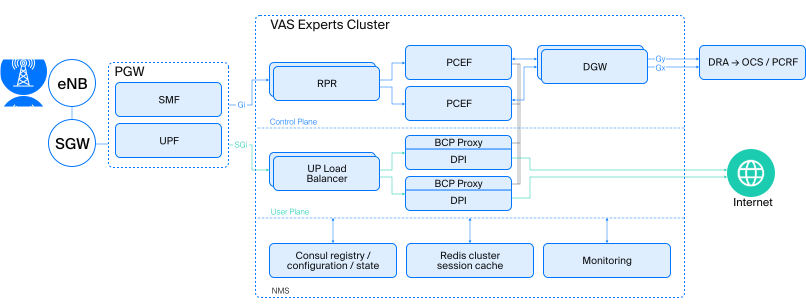
Figure 1 — Architecture du cluster
Le Control Plane stocke l’état des sessions des abonnés et attribue le User Plane. En fonction du nombre de nœuds actifs, il détermine quel nœud dessert un abonné donné, quels paramètres et services lui sont associés et effectue la migration de la session lorsque cette affectation change.
Le principe fondamental dont tout découle
Commençons non pas par la mise à l’échelle elle-même, mais par la contrainte qui la rend plus complexe.
La classification du trafic et la comptabilisation par service exigent que les deux directions d’une connexion soient traitées par le même nœud DPI (User Plane).
De plus, l’unité de service n’est pas une adresse IP individuelle, ni même une seule connexion. Un abonné peut utiliser plusieurs services simultanément, avoir plusieurs connexions, utiliser IPv4 et IPv6 ou partager l’accès à Internet avec d’autres appareils. Ainsi, un même abonné peut avoir plusieurs connexions et adresses, mais du point de vue du service, elles appartiennent toutes à une seule session de service. Cette session devient l’unité de mise à l’échelle : toutes les connexions associées à l’abonné doivent être traitées ensemble par le même nœud de traitement du trafic et le même nœud de contrôle.
L’unité de mise à l’échelle n’est ni un flux, ni une adresse, ni une connexion individuelle, mais la session de service elle-même avec tous ses paramètres : connexions, adresses IPv4 et IPv6, offre tarifaire, quota et données de comptabilisation. Il s’agit de l’unité de distribution, qui ne peut pas être répartie entre plusieurs nœuds.
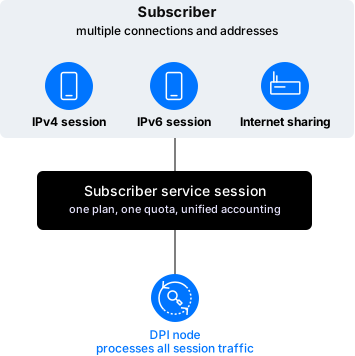
Figure 2 — Session de service : toutes les connexions et adresses d’un abonné constituent une seule unité de service
Si les paquets appartenant à la même connexion TCP arrivent sur des nœuds différents, cela peut entraîner une interruption de la connexion, la perte du contexte de classification et la répartition d’une même session entre plusieurs nœuds pour la comptabilisation du trafic.
C’est particulièrement visible dans le cas du NAT. Si la traduction d’adresse et de port est stockée sur l’ancien nœud alors que le paquet suivant arrive sur un nouveau nœud, ce dernier ne trouvera pas l’entrée correspondante et le trafic sera abandonné. Pour une connexion établie, cela entraîne une interruption.
Deux méthodes pour répartir les abonnés entre les nœuds et leurs différences
Comment répartir les nouvelles sessions entre les nœuds de manière à ce que les paquets de chaque session donnée arrivent toujours sur le même nœud ?
Hachage par identifiant d’abonné
Une méthode courante et efficace consiste à calculer un hash à partir de la paire IMSI/APN de la session PDN de l’abonné. Nous prenons l’identifiant de l’abonné, IMSI+APN, calculons son hash, comparons le résultat à la liste des nœuds actifs et obtenons le numéro du nœud auquel la session doit être envoyée. Comme un abonné possède un seul IMSI, toutes ses sessions dans le même APN, quelle que soit l’adresse IP utilisée (IPv4 ou IPv6), sont dirigées vers le même nœud de traitement. Cette méthode ne nécessite pas de synchroniser l’état entre les nœuds : tant que chacun dispose des mêmes informations sur la composition du cluster, ils calculent indépendamment le même hash et le même numéro de nœud.
Lorsqu’un nouveau nœud est ajouté, un algorithme tel que Maglev ou Randevu reconstruit la distribution afin que le routage ne change que pour une partie minimale des abonnés — environ 1/(N+1) du total lorsque le cluster passe de N à N+1 nœuds. Les autres continuent d’être traités par les mêmes nœuds.
Mais cette méthode présente également une limitation fondamentale : l’algorithme ne tient pas compte de l’état actuel de la session sur le nœud.
Dès qu’un nouveau nœud est ajouté au cluster, le résultat du hash change pour certains abonnés. L’algorithme dirige alors leurs nouvelles connexions vers un autre nœud. Dans le même temps, l’ancien nœud peut encore contenir le contexte de service de ces abonnés : informations sur les connexions, compteurs de consommation et autres données nécessaires au traitement des sessions en cours. Le nouveau nœud ne dispose pas encore de cet état. Si la nouvelle distribution est appliquée immédiatement, les sessions actives se retrouveront sur des nœuds qui ne possèdent pas leur contexte. Il ne suffit donc pas de garantir que chaque connexion individuelle arrive sur le bon nœud. Le contexte associé à l’abonné doit lui aussi rester intact.
Affectation initiale et migration contrôlée
Le hachage ne résout qu’une partie du problème : la distribution initiale. La question suivante est : « Que faire des sessions qui sont déjà actives ? » Pour résoudre ce problème, il est utile de distinguer deux processus : l’affectation initiale des nouvelles sessions et la migration contrôlée des sessions existantes.
Migration contrôlée
Le hachage continue d’être utilisé pour les nouvelles sessions : il répartit rapidement et uniformément la charge et sert également de mécanisme de secours si le Control Plane est temporairement indisponible. En revanche, les sessions actives nécessitent un mécanisme distinct permettant de les redistribuer progressivement.
Cette fonction est assurée par PCEF, un composant du Control Plane. Lorsque le nombre de nœuds DPI change, PCEF parcourt toutes ses sessions. Pour chacune d’elles, il compare l’affectation actuelle au nœud avec l’affectation cible calculée à l’aide d’un hachage cohérent en fonction du nouveau nombre de nœuds. Si elles diffèrent, PCEF bascule la session vers le nœud cible. C’est ainsi qu’une migration progressive du User Plane est mise en œuvre.
Ainsi, lorsqu’un nouveau nœud de traitement du trafic est ajouté, le Control Plane n’a pas besoin de recalculer l’ensemble du système depuis le début. Il peut sélectionner uniquement les sessions concernées par la migration.
La mise à l’échelle du Control Plane lui-même — c’est-à-dire des instances PCEF — fonctionne de manière similaire. Lorsque leur nombre augmente, chaque PCEF actif parcourt les sessions qu’il dessert actuellement et libère celles qui, selon le nouveau hash, doivent désormais appartenir à l’instance nouvellement ajoutée. Si le nombre d’instances PCEF diminue — par exemple parce qu’une instance tombe en panne — les instances restantes parcourent non seulement leurs propres sessions, mais toutes les sessions du stockage partagé. Elles identifient celles qui se retrouvent sans propriétaire et prennent en charge celles qui, selon le hash actuel, leur appartiennent désormais.
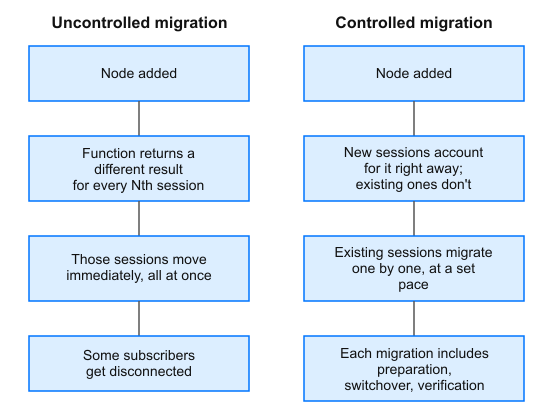
Figure 3 — Deux méthodes de répartition des sessions d’abonnés entre les nœuds
Par exemple, un opérateur ajoute un nouveau nœud DPI. Les nouvelles connexions commencent immédiatement à lui être attribuées. Le Control Plane sélectionne ensuite progressivement certaines sessions actives et les déplace depuis les nœuds surchargés. Une fois l’état préparé, l’affectation est modifiée et le trafic suivant emprunte le nouveau chemin.
Pour l’abonné, rien ne change fondamentalement : l’appel vidéo continue, le téléchargement d’un fichier ne doit pas recommencer et les données de comptabilisation déjà accumulées sont conservées.
Le load balancer du UP lui-même ne prend pas la décision de redistribuer les sessions. Il reçoit la commande, prépare l’état de la session et poursuit le traitement après le basculement. Il s’agit d’une différence fondamentale avec une architecture dans laquelle chaque nœud calcule indépendamment son affectation à l’aide d’un hash.
Les rôles sont ainsi clairement séparés : le Control Plane calcule l’affectation cible et effectue la migration, tandis que le User Plane traite le trafic conformément à cette affectation.
Pour en savoir plus sur le Control Plane et le User Plane, consultez l’article — CUPS pour PCEF/PGW : pourquoi séparer le Control Plane et le User Plane dans le cœur de réseau mobile.
Le coût du contrôle
Pour que la migration contrôlée fonctionne correctement, il faut garantir la cohérence des données utilisées par PCEF pour prendre ses décisions, contrôler la vitesse de migration et gérer les sessions dont l’état ne peut pas être migré en toute sécurité, comme dans le cas du NAT.
Cohérence des informations sur les nœuds
Les nœuds du User Plane ne calculent pas eux-mêmes les affectations : ils les reçoivent du Control Plane et les appliquent lors du traitement du trafic. Il est donc important de s’assurer que chaque nœud travaille bien avec la version à jour.
Chaque fois que le nombre de nœuds change, PCEF calcule le nœud cible pour chaque session en fonction du nouveau nombre de nœuds DPI, qu’il récupère dans Consul. Si plusieurs instances PCEF sont présentes dans le cluster, il est important qu’elles voient toutes le même nombre de nœuds au même moment. Dans le cas contraire, différentes instances PCEF peuvent calculer des nœuds cibles différents pour une même session et la distribution ne sera plus cohérente.
La migration prend du temps
La migration d’une seule session prend une fraction de seconde, mais il peut y avoir des millions de sessions et elles doivent être migrées séquentiellement, et non toutes en même temps. La migration prend du temps, mais les sessions actives restent ininterrompues.
Tout ne peut pas être migré
Enfin, toutes les sessions ne sont pas aussi facilement migrables. Certaines parties de leur état peuvent être copiées en toute sécurité vers un autre nœud, tandis que d’autres sont étroitement liées au matériel spécifique sur lequel la session a été créée. Le NAT est l’un de ces cas : l’entrée de traduction d’adresse et de port existe uniquement dans la mémoire d’un nœud donné et ne peut pas être simplement recréée sur un autre nœud sans risquer de perdre des connexions déjà établies.
Ces sessions sont donc gérées autrement : non pas par migration, mais par terminaison naturelle. Le nœud cesse d’accepter de nouvelles sessions, tandis que les sessions existantes continuent d’y être traitées jusqu’à leur fin naturelle.
Comment vérifier que cela fonctionne : trois critères mesurables
Tout ce qui est décrit ci-dessus — le hachage basé sur l’IMSI et la migration contrôlée — vise à garantir trois propriétés précises qui peuvent être mesurées sur du trafic réel plutôt que simplement déclarées.
| Propriété | Comment la vérifier | En cas de non-respect |
| Les deux directions d’une session sur le même nœud | Vérifier que le trafic entrant et sortant d’une même session est traité sur le même nœud | La comptabilisation et la classification par service peuvent être incomplètes |
| Migration sans perte de paquets | Vérifier que le trafic continue sans interruption pendant la migration de la session | L’abonné peut subir une interruption de connexion |
| Migration sans perte des données de comptabilisation | Vérifier que le volume total comptabilisé sur le nœud d’origine et le nouveau nœud correspond à la consommation réelle | Une erreur de comptabilisation peut n’apparaître qu’au moment de la génération du rapport final |
La troisième propriété mérite une attention particulière. Lors d’une migration contrôlée, le nœud d’origine transmet les données finales de consommation avant la fin de la session. Le Control Plane les combine avec les données du nouveau nœud et ajuste le seuil de consommation. Les données ne sont ainsi ni perdues ni comptabilisées deux fois.
Il n’est pas non plus nécessaire de fermer puis de rouvrir la session de tarification. L’abonné continue à utiliser le service sans interruption, tandis que la comptabilisation de la consommation se poursuit en tenant compte des données des deux nœuds.
Ce que cette approche de mise à l’échelle apporte
Le principal avantage de cette approche est que l’opérateur peut modifier la composition de l’infrastructure sans redistribuer massivement les sessions actives. Un nouveau nœud peut être utilisé immédiatement pour les nouvelles connexions, tandis que les sessions existantes peuvent être migrées progressivement selon les besoins.
Cela produit plusieurs effets pratiques :
- La capacité peut être augmentée sans arrêter le réseau. Le nouveau nœud commence immédiatement à accepter des connexions, tandis que les sessions actives sont migrées en arrière-plan.
- La charge est rééquilibrée de manière ciblée. Un nœud surchargé est déchargé exactement dans la mesure nécessaire, plutôt que par un recalcul complet des connexions.
- L’état de l’abonné reste intact. Les connexions, adresses, offre tarifaire, quota et comptabilisation par service restent associés à l’abonné au lieu d’être répartis entre plusieurs nœuds.
- Les opérations de maintenance planifiées ne se transforment pas en basculements d’urgence. Lorsqu’un nœud est retiré du service, ses sessions peuvent être migrées à l’avance vers d’autres nœuds au lieu d’interrompre toutes les connexions simultanément.
La croissance du réseau se mesure en térabits, tandis que le résultat de la mise à l’échelle se ressent au niveau d’une connexion individuelle. Une architecture dans laquelle l’unité de distribution n’est ni un flux ni même une session individuelle, mais l’abonné avec tout ce qui lui est associé, ne permet tout simplement pas de négliger cette exigence au stade de la conception.